Μια ιστοσελίδα μπορεί να είναι όμορφη, γρήγορη και γεμάτη χρήσιμο περιεχόμενο, αλλά αυτό από μόνο του δεν σημαίνει ότι η Google μπορεί να τη βρει, να την κατανοήσει και να την εμφανίσει σωστά στα αποτελέσματα αναζήτησης. Εδώ ακριβώς μπαίνει το Technical SEO.
Το Technical SEO αφορά την τεχνική βάση πάνω στην οποία στηρίζεται η οργανική παρουσία μιας ιστοσελίδας. Πριν εξετάσουμε keywords, περιεχόμενο ή θέσεις στη Google, πρέπει πρώτα να βεβαιωθούμε ότι οι μηχανές αναζήτησης μπορούν να ανακαλύψουν τις σωστές σελίδες, να τις ανιχνεύσουν, να τις επεξεργαστούν και τελικά να τις ευρετηριάσουν.
Ακούγεται τεχνικό, αλλά η βασική λογική είναι απλή.
Για να εμφανιστεί μια σελίδα στη Google, πρέπει πρώτα να μπορεί να τη βρει.
Τι είναι το Technical SEO;
Το Technical SEO είναι το κομμάτι του SEO που ασχολείται με τον τρόπο με τον οποίο μια ιστοσελίδα επικοινωνεί τεχνικά με τις μηχανές αναζήτησης.
Δεν αφορά μόνο την ταχύτητα της σελίδας ή ένα καλό σκορ σε κάποιο εργαλείο. Περιλαμβάνει ολόκληρη τη διαδικασία με την οποία η Google ανακαλύπτει και κατανοεί τις σελίδες ενός website.
Μερικά από τα βασικά στοιχεία του Technical SEO είναι:
- η δυνατότητα crawling των σελίδων
- η σωστή ευρετηρίαση
- η δομή των URLs
- το XML sitemap
- το robots.txt
- τα canonical URLs
- τα redirects
- τα internal links
- τα structured data
- η mobile λειτουργία
- η απόδοση και η τεχνική σταθερότητα της ιστοσελίδας
Όλα αυτά λειτουργούν μαζί.
Δεν χρειάζεται κάθε website να έχει πολύπλοκη τεχνική αρχιτεκτονική. Χρειάζεται όμως να μην δημιουργεί εμπόδια στη Google.
Crawling και Indexing δεν είναι το ίδιο πράγμα
Οι δύο όροι χρησιμοποιούνται συχνά σαν να σημαίνουν το ίδιο, αλλά περιγράφουν διαφορετικά στάδια.
Crawling
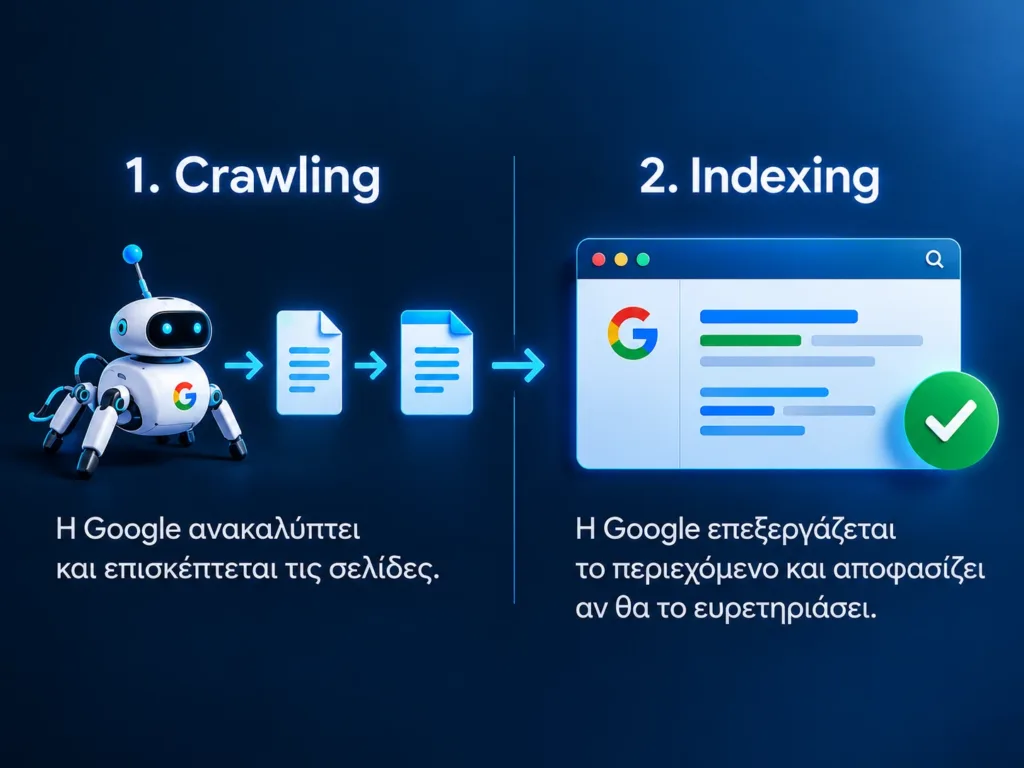
Το crawling είναι η διαδικασία κατά την οποία τα συστήματα της Google ανακαλύπτουν και επισκέπτονται URLs.
Η Google μπορεί να βρει μια σελίδα μέσω:
- ενός internal link
- ενός external link
- ενός XML sitemap
- μιας ήδη γνωστής σελίδας του website
- προηγούμενης ανίχνευσης
Όταν η Googlebot επισκεφθεί τη σελίδα, προσπαθεί να διαβάσει το περιεχόμενο και να καταλάβει τη δομή της.
Αυτό όμως δεν σημαίνει ότι η σελίδα θα προστεθεί αυτόματα στο index.
Indexing
Το indexing είναι το επόμενο στάδιο.
Η Google επεξεργάζεται τη σελίδα και αποφασίζει αν θα την προσθέσει στο ευρετήριό της.
Με απλά λόγια:
- Crawling σημαίνει ότι η Google βρήκε τη σελίδα.
- Indexing σημαίνει ότι αποφάσισε να την αποθηκεύσει και να μπορεί να την εμφανίσει στα αποτελέσματα αναζήτησης.
Μια σελίδα μπορεί επομένως να έχει γίνει crawl αλλά να μην έχει γίνει indexed.
Και αυτό είναι ένα από τα πιο συνηθισμένα σημεία σύγχυσης όταν κάποιος βλέπει στο Google Search Console ότι μια URL έχει ανιχνευθεί αλλά δεν εμφανίζεται στη Google.
Πώς ανακαλύπτει η Google τις σελίδες μιας ιστοσελίδας;
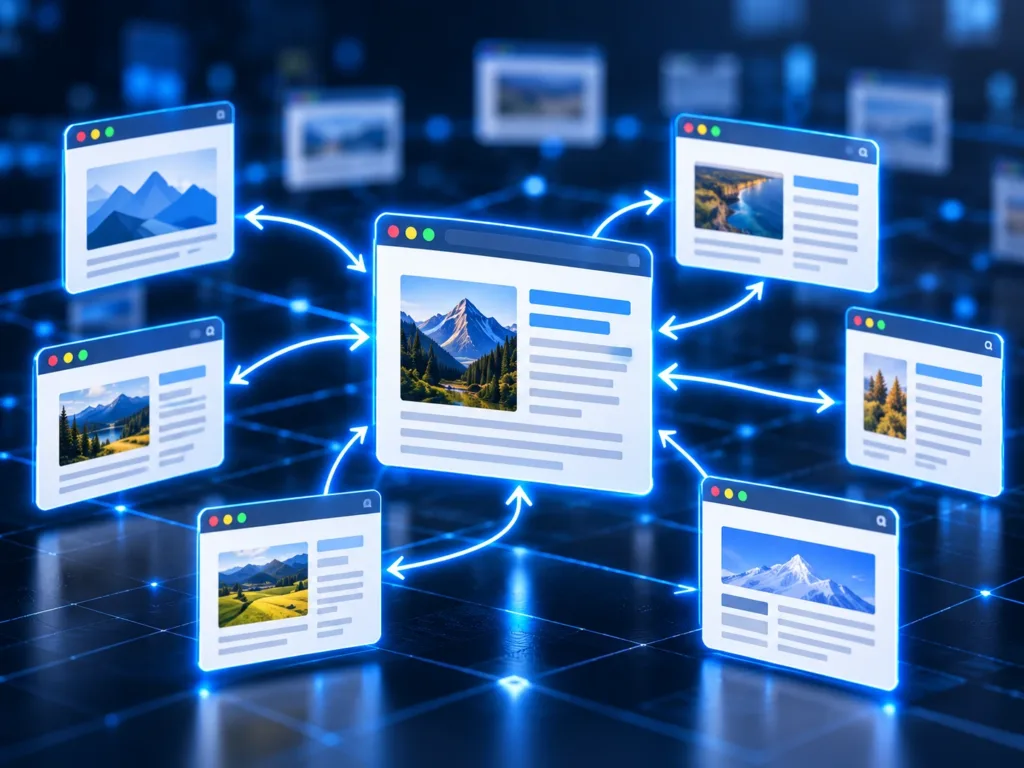
Η Google δεν γνωρίζει αυτόματα κάθε νέα URL που δημιουργείται. Πρέπει να υπάρχει κάποιος τρόπος να τη βρει. Ένα από τα σημαντικότερα στοιχεία είναι η εσωτερική δομή της ιστοσελίδας. Αν μια νέα σελίδα συνδέεται φυσικά από άλλες σχετικές σελίδες, η Google έχει ξεκάθαρη διαδρομή προς αυτή. Γι’ αυτό τα internal links δεν υπάρχουν μόνο για τον επισκέπτη.
Βοηθούν και τις μηχανές αναζήτησης να καταλάβουν:
- ποιες σελίδες υπάρχουν
- πώς σχετίζονται μεταξύ τους
- ποιες είναι πιο σημαντικές
- ποιο είναι το θεματικό πλαίσιο κάθε σελίδας
Μια σελίδα που υπάρχει τεχνικά αλλά δεν συνδέεται από πουθενά μπορεί να μετατραπεί σε αυτό που αποκαλούμε orphan page.
Και αυτό δεν είναι ιδιαίτερα καλή βάση για οργανική ανάπτυξη.
Ο ρόλος του XML Sitemap
Το XML sitemap λειτουργεί σαν ένας οργανωμένος κατάλογος URLs που θέλουμε να γνωρίζουν οι μηχανές αναζήτησης. Δεν εξασφαλίζει ότι μια σελίδα θα γίνει indexed. Βοηθά όμως τη Google να ανακαλύψει πιο εύκολα τις URLs που θεωρούμε σημαντικές. Ένα σωστό sitemap θα πρέπει να περιλαμβάνει τις πραγματικές canonical σελίδες του website και όχι:
- redirects
- URLs που επιστρέφουν error
- σελίδες με noindex
- διπλότυπες εκδόσεις
- προσωρινές ή άχρηστες URLs
Το sitemap είναι ιδιαίτερα σημαντικό σε μεγαλύτερα websites, e-shops ή συστήματα όπου δημιουργούνται συχνά νέες σελίδες.
Τι κάνει πραγματικά το robots.txt;
Το robots.txt χρησιμοποιείται για να δώσει οδηγίες στους crawlers σχετικά με το ποιες περιοχές ενός website μπορούν ή δεν μπορούν να ανιχνεύσουν. Εδώ υπάρχει μια σημαντική λεπτομέρεια. Το robots.txt ελέγχει κυρίως το crawling. Δεν αποτελεί από μόνο του ασφαλή μηχανισμό αφαίρεσης μιας URL από το index.
Αν θέλουμε μια σελίδα να μην ευρετηριαστεί, συνήθως εξετάζουμε τη χρήση του noindex.
Και υπάρχει ακόμη μια λεπτομέρεια που συχνά δημιουργεί προβλήματα. Αν εμποδίσουμε εντελώς την πρόσβαση μιας σελίδας μέσω robots.txt, η Google μπορεί να μην μπορέσει να επισκεφθεί τη σελίδα ώστε να δει το noindex.
Γι’ αυτό οι τεχνικές οδηγίες πρέπει να χρησιμοποιούνται με συγκεκριμένο σκοπό και όχι μηχανικά.
Canonical URLs και διπλό περιεχόμενο
Σε αρκετά websites το ίδιο ή πολύ παρόμοιο περιεχόμενο μπορεί να εμφανίζεται μέσα από περισσότερες από μία URLs.
Παραδείγματα μπορεί να είναι:
- παραλλαγές URLs με parameters
- εκδόσεις φίλτρων
- duplicate category pages
- HTTP και HTTPS εκδόσεις
- URLs με και χωρίς συγκεκριμένη δομή
Το canonical tag βοηθά να δηλώσουμε ποια URL θεωρούμε ως την κύρια έκδοση. Δεν είναι εντολή που υποχρεώνει τη Google να επιλέξει συγκεκριμένη URL. Είναι ένα ισχυρό σήμα. Όταν όμως canonicals, internal links, sitemap και redirects δείχνουν προς διαφορετικές κατευθύνσεις, δημιουργείται ασάφεια. Το σωστό Technical SEO προσπαθεί να κάνει όλα αυτά τα signals συνεπή μεταξύ τους.
Redirects: πότε βοηθούν και πότε δημιουργούν προβλήματα
Τα redirects είναι απαραίτητα όταν μια URL αλλάζει. Αν μια παλιά σελίδα αντικατασταθεί από μια νέα, ένα σωστό 301 redirect βοηθά τον επισκέπτη και τη μηχανή αναζήτησης να φτάσουν στον νέο προορισμό. Το πρόβλημα ξεκινά όταν δημιουργούνται:
- redirect chains
- redirects προς άσχετες σελίδες
- loops
- παλιές URLs χωρίς κανέναν προορισμό
- internal links που εξακολουθούν να δείχνουν στις παλιές URLs
Ένα καθαρό website πρέπει, όπου είναι δυνατό, να συνδέεται απευθείας με τον τελικό προορισμό.
Το redirect είναι μηχανισμός μετάβασης, όχι μόνιμη αρχιτεκτονική.
Technical SEO και On-page SEO
Το Technical SEO δεν αντικαθιστά το On-page SEO. Τα δύο λειτουργούν συμπληρωματικά.
Το Technical SEO φροντίζει ώστε η μηχανή αναζήτησης να μπορεί να προσπελάσει και να επεξεργαστεί σωστά τη σελίδα.
Το On-page SEO βοηθά να καταλάβει τι αφορά η συγκεκριμένη σελίδα και γιατί μπορεί να είναι χρήσιμη για μια αναζήτηση.
Στο On-page SEO εξετάζουμε στοιχεία όπως:
- το SEO title
- το meta description
- το H1
- τη σωστή ιεραρχία H2 και H3
- το κυρίως περιεχόμενο
- τη σχέση του περιεχομένου με το search intent
- τα internal links
- τις εικόνες και τα alt attributes
- τη σαφήνεια του URL
- τα calls to action
Ένα άριστο άρθρο με κακό technical setup μπορεί να δυσκολευτεί να αξιοποιηθεί. Αλλά και μια τεχνικά τέλεια σελίδα χωρίς χρήσιμο περιεχόμενο δεν έχει ιδιαίτερο λόγο να καταταχθεί. Το SEO χρειάζεται και τα δύο.
JavaScript και σύγχρονες ιστοσελίδες
Οι σύγχρονες ιστοσελίδες χρησιμοποιούν όλο και περισσότερο JavaScript, frameworks και δυναμικά δεδομένα. Αυτό από μόνο του δεν είναι πρόβλημα. Η Google μπορεί να επεξεργαστεί JavaScript, αλλά η αρχιτεκτονική πρέπει να έχει σχεδιαστεί σωστά. Το πραγματικό ερώτημα δεν είναι αν χρησιμοποιείται React, Next.js ή κάποια άλλη τεχνολογία.
Το ερώτημα είναι αν:
- το βασικό περιεχόμενο είναι προσβάσιμο
- υπάρχουν πραγματικές URLs
- τα internal links μπορούν να ακολουθηθούν
- το metadata είναι σωστό
- η σελίδα επιστρέφει το σωστό HTTP status
- το canonical είναι συνεπές
- η Google βλέπει το ίδιο ουσιαστικό περιεχόμενο που βλέπει και ο χρήστης
Η τεχνολογία πρέπει να υπηρετεί τη δυνατότητα ανακάλυψης της πληροφορίας, όχι να την εμποδίζει.
Γιατί μια σελίδα μπορεί να μην εμφανίζεται στη Google;
Δεν υπάρχει μία μόνο αιτία.
Μερικές από τις συχνότερες είναι:
- η Google δεν έχει ακόμη ανακαλύψει την URL
- η σελίδα δεν έχει επαρκή internal links
- υπάρχει noindexκάποιο technical rule εμποδίζει το crawling
- υπάρχει λάθος canonical
- η URL κάνει redirect
- ο server επιστρέφει λάθος status code
- το περιεχόμενο είναι πολύ παρόμοιο με άλλη σελίδα
- η Google θεωρεί ότι κάποια άλλη URL είναι καλύτερη canonical έκδοση
- το περιεχόμενο δεν προσφέρει αρκετή ξεχωριστή αξία
- η σελίδα είναι πολύ νέα και δεν έχει ακόμη επεξεργαστεί
Το σημαντικό είναι να μη βγάζουμε συμπέρασμα μόνο από το γεγονός ότι μια URL δεν εμφανίζεται στην αναζήτηση.
Πρώτα χρειάζεται διάγνωση.
Google Search Console: το βασικό εργαλείο διάγνωσης
Το Google Search Console είναι ένα από τα σημαντικότερα εργαλεία για να καταλάβουμε πώς βλέπει η Google την ιστοσελίδα. Με το URL Inspection μπορούμε να εξετάσουμε μια συγκεκριμένη URL και να δούμε πληροφορίες σχετικά με:
- την κατάσταση ευρετηρίασης
- την τελευταία ανίχνευση
- το canonical
- πιθανά προβλήματα
- αν η σελίδα είναι διαθέσιμη στη Google
Το Search Console δεν πρέπει όμως να αντιμετωπίζεται μόνο σαν εργαλείο όπου πατάμε Request indexing. Η πραγματική αξία του βρίσκεται στη διάγνωση. Αν μια σημαντική σελίδα δεν ευρετηριάζεται, το σωστό ερώτημα είναι πρώτα “γιατί;” και όχι απλώς “πώς θα αναγκάσω τη Google να την κάνει index;“.
Ένα απλό Technical SEO checklist
Αν θέλεις να κάνεις έναν πρώτο έλεγχο στο website σου, μπορείς να ξεκινήσεις από αυτά:
- Η URL ανοίγει κανονικά;
Η σελίδα πρέπει να επιστρέφει το σωστό status και να μην οδηγεί κατά λάθος σε redirect ή error. - Είναι indexable;
Έλεγξε αν υπάρχει noindex ή κάποια άλλη οδηγία που αποκλείει την ευρετηρίαση. - Υπάρχει σωστό canonical;
Το canonical πρέπει να δείχνει στη σωστή έκδοση της σελίδας. - Υπάρχει στο sitemap;
Οι σημαντικές canonical σελίδες πρέπει να εμφανίζονται στο XML sitemap. - Υπάρχουν internal links;
Η σελίδα πρέπει να αποτελεί φυσικό μέρος της αρχιτεκτονικής του website. - Το περιεχόμενο είναι μοναδικό και χρήσιμο;
Η τεχνική πρόσβαση από μόνη της δεν αρκεί. - Το metadata περιγράφει σωστά τη σελίδα;
SEO title, description και heading structure πρέπει να υποστηρίζουν το πραγματικό θέμα της σελίδας. - Τι δείχνει το Search Console;
Το URL Inspection και οι αναφορές indexing μπορούν να δώσουν σημαντικές ενδείξεις πριν αρχίσουμε να αλλάζουμε πράγματα χωρίς λόγο.
Το Technical SEO δεν είναι εφάπαξ εργασία
Μια ιστοσελίδα αλλάζει συνεχώς. Δημιουργούνται νέες σελίδες, αλλάζουν URLs, αφαιρούνται προϊόντα, γίνονται redesigns, εγκαθίστανται plugins, αλλάζει το frontend ή προστίθενται integrations. Μια αλλαγή που φαίνεται μικρή μπορεί να επηρεάσει:
- redirects
- canonicals
- sitemap
- metadata
- internal links
- structured data
- crawling
- indexing
Γι’ αυτό το Technical SEO δεν είναι κάτι που ελέγχουμε μία φορά και θεωρούμε ότι τελείωσε. Χρειάζεται περιοδικός έλεγχος και, κυρίως, έλεγχος μετά από σημαντικές αλλαγές στο website. Πρώτα να μπορεί να βρεθεί. Μετά να ανταγωνιστεί. Πριν μιλήσουμε για rankings, keywords και περισσότερη οργανική επισκεψιμότητα, πρέπει να υπάρχει σωστή τεχνική βάση. Η Google πρέπει να μπορεί να βρει τις σημαντικές σελίδες, να καταλάβει ποια έκδοση είναι η σωστή και να επεξεργαστεί το περιεχόμενο χωρίς αντικρουόμενα signals. Από εκεί και πέρα ξεκινά το πραγματικό SEO. Περιεχόμενο, search intent, authority, εμπειρία χρήστη και συνεχής βελτίωση μπορούν να αποδώσουν πολύ περισσότερο όταν η τεχνική βάση δεν τα εμποδίζει.
Συχνές ερωτήσεις για Technical SEO, Crawling και Indexing
Crawling είναι η διαδικασία με την οποία οι μηχανές αναζήτησης ανακαλύπτουν και επισκέπτονται URLs. Η Google χρησιμοποιεί crawlers, όπως το Googlebot, για να ακολουθεί links και να επεξεργάζεται το περιεχόμενο των σελίδων.
Indexing είναι η διαδικασία κατά την οποία η Google επεξεργάζεται μια σελίδα και αποφασίζει αν θα την προσθέσει στο ευρετήριό της. Μια URL μπορεί να έχει γίνει crawl χωρίς απαραίτητα να έχει γίνει indexed.
Μπορεί να υπάρχουν πολλοί λόγοι, όπως διπλό ή χαμηλής αξίας περιεχόμενο, προβλήματα canonical, περιορισμένα internal links ή απλώς το γεγονός ότι η Google δεν θεωρεί ακόμη απαραίτητη την ευρετηρίαση της συγκεκριμένης URL.
Όχι. Το sitemap βοηθά στην ανακάλυψη των URLs, αλλά δεν αποτελεί εγγύηση ότι η Google θα τις ευρετηριάσει ή θα τις κατατάξει.
Όχι με αξιόπιστο τρόπο. Το robots.txt ελέγχει κυρίως την πρόσβαση των crawlers. Για τον αποκλεισμό μιας σελίδας από το index χρησιμοποιούνται άλλοι μηχανισμοί, όπως το noindex, ανάλογα με την περίπτωση.
Δεν υπάρχει συγκεκριμένος χρόνος. Μπορεί να γίνει γρήγορα ή να χρειαστούν ημέρες ή περισσότερο. Παίζουν ρόλο η αρχιτεκτονική του website, τα internal links, η συχνότητα crawling, η ποιότητα του περιεχομένου και άλλα signals.
Όχι. Ακόμη και ένα μικρό επαγγελματικό website μπορεί να έχει λάθος redirects, noindex, canonicals, sitemap ή internal linking. Απλώς όσο μεγαλώνει ένα website, τόσο μεγαλύτερη γίνεται η ανάγκη για συστηματικό τεχνικό έλεγχο.
Η πλατφόρμα λύνει αρκετά τεχνικά θέματα, αλλά δεν εγγυάται ότι η τελική υλοποίηση είναι σωστή. Plugins, themes, εφαρμογές, custom κώδικας, redirects και ρυθμίσεις μπορούν να επηρεάσουν την τεχνική εικόνα του site.
Θέλεις να ξέρεις τι βλέπει πραγματικά η Google στο website σου;
Ένα Technical SEO review μπορεί να δείξει αν υπάρχουν εμπόδια στο crawling, στο indexing, στα canonicals, στα redirects, στο sitemap ή στη συνολική αρχιτεκτονική της ιστοσελίδας.
Στην Artificial System ξεκινάμε από την πραγματική κατάσταση του website και τα δεδομένα του Search Console, ώστε να εντοπίσουμε πρώτα τι χρειάζεται βελτίωση και τι όχι.